Il y a des journées de formation où l'on passe d'un rôle à son exact opposé en quelques heures. Aujourd'hui, le programme tenait en deux actes : d'abord bâtir l'infrastructure de surveillance, ensuite l'investiguer. Deux exercices, deux compétences, une même plateforme au centre : Wazuh.
Wazuh, pour planter le décor, c'est un SIEM open-source : il centralise les journaux de tout un parc de machines, les passe au crible de règles de détection, et fait remonter des alertes hiérarchisées par niveau de gravité. C'est l'équivalent d'une tour de contrôle pour une infrastructure. Encore faut-il la construire avant de pouvoir s'asseoir dedans.
Acte I — Déploiement : monter le MVP de surveillance
Le premier exercice posait un cahier des charges très « vie réelle » : le client doit répondre à des obligations de conformité (SOC2, ISO 27001) et veut détecter les accès non autorisés, les modifications de fichiers suspectes et les escalades de privilèges. Mission du jour : livrer un MVP — un socle minimal mais fonctionnel — surveillé par Wazuh.
Tout s'est monté dans VMware, un hyperviseur qui permet de faire tourner plusieurs machines virtuelles et de les câbler entre elles. La topologie cible tenait en trois briques :
wazuh-manager — le serveur Ubuntu qui héberge le backend SIEM et le dashboard.
lab-server — une machine Ubuntu jouant le rôle de serveur métier, équipée d'un agent Wazuh.
Windows Desktop — le poste type d'un employé, lui aussi sous agent Wazuh.
Le principe est simple : on installe le manager, puis on déploie un agent léger sur chaque machine à surveiller. L'agent collecte les événements locaux (connexions, intégrité des fichiers, journaux système) et les remonte au manager, qui les corrèle et alerte. Une fois les deux agents enregistrés et visibles dans le dashboard, la preuve était faite : des logs remontaient bel et bien.
Pour pousser un peu plus loin que le strict minimum, on a ajouté Suricata en IDS/IPS au tableau — un moteur d'inspection du trafic réseau qui détecte les motifs d'attaque connus et fait remonter ses propres alertes dans Wazuh. Détail amusant de la formation : certaines alertes de test portaient des noms de scénarios maison, de quoi vérifier d'un coup d'œil que la chaîne de détection fonctionnait de bout en bout.
La leçon de l'acte I tient en une phrase : déployer un SIEM, c'est surtout brancher correctement des tuyaux. Le plus dur n'est pas l'installation, c'est de s'assurer que chaque agent parle au manager et que les bons événements arrivent bien jusqu'au dashboard.
Acte II — Investigation : devenir l'analyste qui lit les alertes
Changement de casquette pour le second exercice. Cette fois, l'infrastructure existe déjà — pré-remplie de plusieurs mois de logs — et la mission est limpide : investiguer et vérifier que rien ne cloche. On passe du builder à l'analyste SOC.
Premier réflexe, et premier piège : la fenêtre temporelle. Le dashboard affiche par défaut les dernières 24 heures, alors que les données à analyser couraient de janvier à mai 2025. Tant que le sélecteur de dates n'est pas réglé sur la bonne plage — au format exact, de 00:30:00 à 23:30:00 — les compteurs mentent. J'ai d'ailleurs failli valider un comptage faux de 12 alertes simplement parce que mes bornes débordaient de quelques heures.
Tout le travail s'est fait dans le module Threat Hunting, en interrogeant l'indexeur avec des requêtes DQL. C'est là que le métier d'analyste devient concret : on filtre, on trie, on déplie un document pour lire ses champs réels, et on raconte une histoire.
Compter les alertes critiques
Compter les alertes critiques revient à poser une requête simple et à lire le total de hits — surtout pas à multiplier le nombre de pages :
rule.level >= 15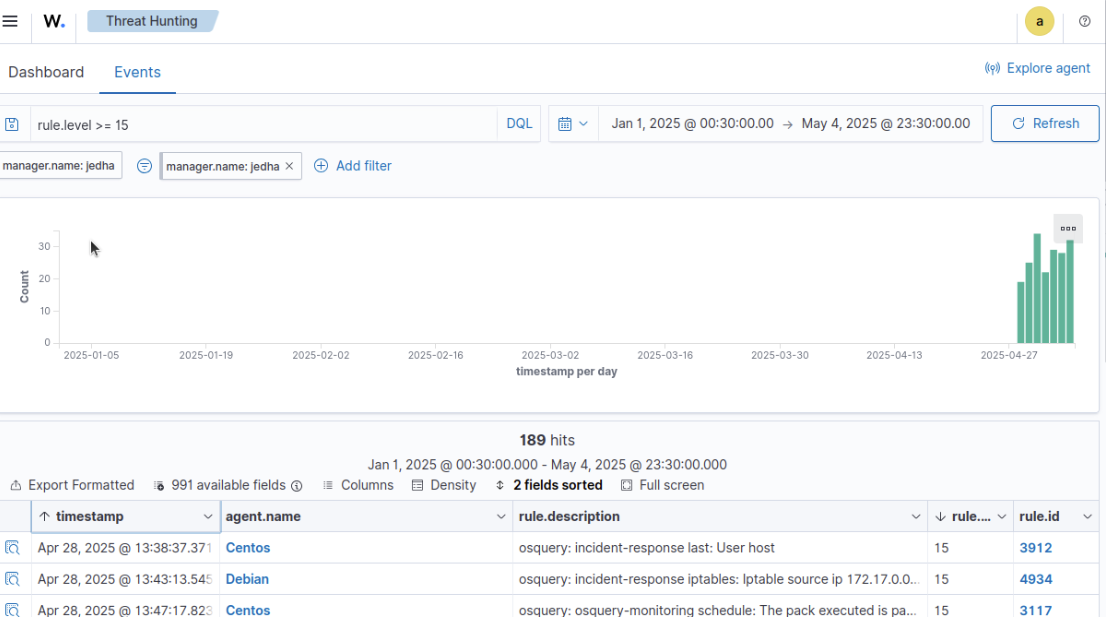
Résultat : 189 alertes de niveau critique (≥ 15) sur la fenêtre du 1ᵉʳ janvier au 4 mai 2025, et 2 400 alertes de niveau élevé (12–14). Deux subtilités m'ont fait perdre — puis gagner — du temps. D'abord, un filtre « pill » résiduel rule.level: 7 to 11 traînait sous la barre de recherche et se combinait en ET avec mes requêtes : demander « niveau ≥ 15 ET niveau entre 7 et 11 » renvoie évidemment zéro résultat. Ensuite, dans la recherche d'un log par son identifiant, un caractère ambigu — un l minuscule pris pour un 1 — suffisait à ne rien trouver. Le diable est dans la typographie.
Lire une séquence comme un récit
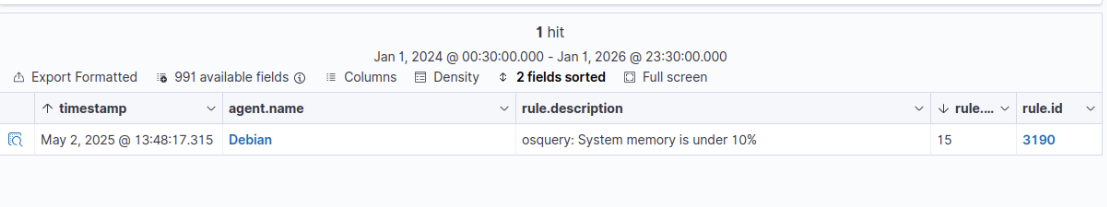
Le cœur de l'investigation, c'est la corrélation. Sur l'agent Debian, un log critique signalait une mémoire anormalement basse. En cherchant ce log précis dans Wazuh :
En regardant ce qui se passait juste après sur la même machine, une histoire s'est dessinée :
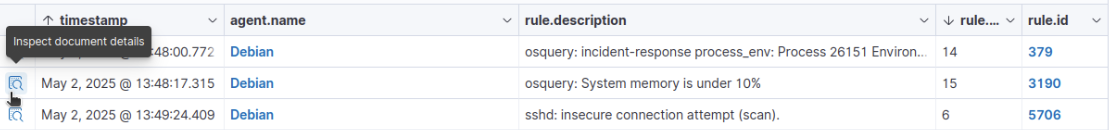
Le 2 mai 2025 à 13:48:17, osquery déclenche une alerte critique (niveau 15) : la mémoire système est sous les 10 %. Une minute plus tard, à 13:49:24, sur le même hôte : sshd détecte une tentative de connexion suspecte (scan). À cela s'ajoutait un autre signal repéré plus tôt — « possible breakin attempt » avec un nombre anormal d'erreurs de résolution inverse — et surtout une concentration de 41 connexions venues d'Espagne, sur le seul agent 007, en une seule journée. Le motif est caractéristique : des tentatives de connexion SSH répétées et massives depuis une origine unique.
Une mémoire qui sature, des scans SSH en rafale, une géolocalisation unique : trois indices isolés qui, mis bout à bout, racontent une attaque par force brute.
Côté MITRE ATT&CK, ce comportement se range sans hésiter sous la technique T1110 — Brute Force (avec, selon le scénario, la sous-technique Password Guessing). C'était la conclusion de l'enquête.
Synthèse de l'investigation
| Indicateur | Valeur |
|---|---|
| Alertes de niveau critique (≥ 15) | 189 |
| Alertes de niveau élevé (12–14) | 2 400 |
| Premier log critique | 28 avr · 13:38:37 |
| Alerte mémoire critique (agent Debian) | memory < 10% |
| Événement suivant sur le même hôte | sshd scan (1 min après) |
| Connexions depuis une même origine étrangère | 41 (agent 007) |
| Technique d'attaque identifiée | T1110 — Brute Force |
Ce que je retiens : deux faces d'un même métier
Enchaîner déploiement et investigation dans la même journée change le regard. Quand on a soi-même branché les agents et réglé les règles le matin, on lit les alertes de l'après-midi avec une autre compréhension : on sait d'où vient chaque champ, pourquoi un événement remonte, et ce que le silence d'un capteur signifierait.
Trois réflexes me suivront sur n'importe quel SIEM : la fenêtre temporelle prime sur tout (c'est la première chose à vérifier devant un compteur bizarre) ; les filtres se combinent en ET, donc un pill oublié peut tout fausser en silence ; et surtout, une alerte isolée ne vaut rien — c'est la séquence d'événements qui raconte l'attaque. Mémoire basse, puis scan SSH, puis rafale de connexions étrangères : pris séparément, du bruit ; mis en récit, une intrusion.
Les prochaines étapes : durcir l'exposition SSH, automatiser le blocage des sources abusives, basculer sur de l'authentification par clé. La tour de guet est debout — reste à bétonner les portes.
Les données de l'environnement sont fictives.